
|
Books 深層学習 Deep Learning |
まとめ中

の自習メモ
\(u = w1 x1 + w2 x2 + w3 x3 + w4 x4 + b \\ z = f(u) \)
\(\left( \begin{array}{c} u_{1} \\ u_{2} \\ u_{3} \end{array} \right) = \left( \begin{array}{c} w_{11} & w_{12} & w_{13} & w_{14} \\ w_{21} & w_{22} & w_{23} & w_{24} \\ w_{31} & w_{32} & w_{33} & w_{34} \end{array} \right) \left( \begin{array}{c} x_{1} \\ x_{2} \\ x_{3} \\ x_{4} \end{array} \right) + \left( \begin{array}{c} b \\ b \\ b \end{array} \right) \\ \left( \begin{array}{c} z_{1} \\ z_{2} \\ z_{3} \end{array} \right) = \left( \begin{array}{c} f(u_{1}) \\ f(u_{2}) \\ f(u_{3}) \end{array} \right) \\ \)
\(\mathsf{u} = \mathsf{W} \mathsf{x} + \mathsf{b} \\ \mathsf{z} = f(\mathsf{u}) \)
| l=1 | 入力層(input layer) |
| l=2 | 中間層(internal layer), 隠れ層(hidden layer) |
| l=3 | 出力層(output layer) |
\(\mathsf{u}^{(l+1)} = \mathsf{W}^{(l+1)} \mathsf{z}^{(l)} + \mathsf{b}^{(l+1)} \\ \mathsf{z}^{(l+1)} = f(\mathsf{u}^{(l+1)}) \\ \\ (ただし \mathsf{z}^{(0)} = \mathsf{x}) \)
\(\mathsf{y} = y(\mathsf{x}; \mathsf{W}^{(2)}, ... , \mathsf{W}^{(L)}, \mathsf{b}^{(2)}, ... , \mathsf{b}^{(L)}) \\ \mathsf{y} = y(\mathsf{x}; \mathsf{W}) \)
とも書く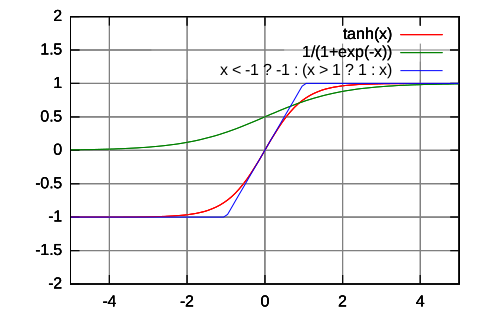
\(f(u) = \frac{1}{1+e^{-u}} \\ \)
\(f(u) = tanh(u) \\ \)
\(f(u) =\begin{cases}-1 & u < -1\\u & -1 \leq u < 1\\ 1 & 1 \leq u\end{cases} \)
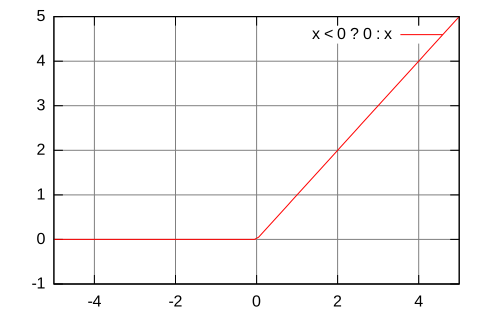
\(f(u) = max(0,u) = \begin{cases}0 & u < 0\\u & 0 \leq u\end{cases} \)
\(f'(u) = \begin{cases}1 & u \geq 0\\0 & u < 0\end{cases} \)
\(u_{jk} = \sum_i \big\{w_{jik} x_{i} + b_{jk}\big\} \\ z_{j} = f(u_{j}) = max_{k=1,...,K} (u_{jk}) \)
\(\mathsf{y} = y(\mathsf{x}; \mathsf{W}) \)
の最適な "W" を学習し、入力 x に対して適切な出力 y が得られるようにしたい\((x,d) \)
\((x_n,d_n)=\big\{(x_1,d_1),(x_2,d_2),...,(x_n,d_n)\big\} \)
\(d_n \approx y(x_n;W) \)
\(E(W) = \frac{1}{2} \sum_{n=1}^{N} \| d_n - y(x_n;W) \|^2 \)
※ 1/2 は、微分した時に係数が出てこないようにするため\(p(d=1|x) = y(x;W) \\ p(d=0|x) = 1 - y(x;W) \\ \therefore p(d|x) = p(d=1|x)^{d}p(d=0|x)^{1-d} \)
\(L(W) = \prod_{n=1}^{N} p(d_{n}|x_{n}) = \prod_{n=1}^{N} p(d=1|x)^{d_{n}}p(d=0|x)^{1-d_{n}} = \prod_{n=1}^{N} y(x;W)^{d_{n}}(1-y(x;W))^{1-d_{n}} \)
\(E(W) = -log(L(W)) = - \sum_{n=1}^N \big\{ d_{n} log(y(x_{n};W)) + (1 - d_{n}) log(1-y(x_{n};W)) \big\} \)
\(y=\frac{1}{1+e^{-u}} \\ d=\begin{cases}0 & y < 0.5\\1 & 0.5 \leq y\end{cases} \)
\(y_{k} = z_{k}^{(L)} = \frac{exp(u_{k}^{(L)})}{ \sum_{j=1}^{K} exp(u_{j}^{(L)}) } \)
softmax function は、合計が 1 になる ⇒ これを入力画像 x が与えられた時の y0〜y9 の確率分布と見なす\(d_{n} = [0\ 0\ 1\ 0\ 0\ 0\ 0\ 0\ 0]^{T} \)
となるのが理想\(L(W) = \prod_{n=1}^N p(d_{n}|x_{n}) = \prod_{n=1}^N \prod_{k=1}^K (y_{k}(x;W))^{d_{nk}} \)
\(E(W) = -log(L(W)) = - \sum_{n=1}^N \sum_{k=1}^K d_{nk} log(y_{k}(x_{n};W)) \)
この関数は交差エントロピー (cross entropy)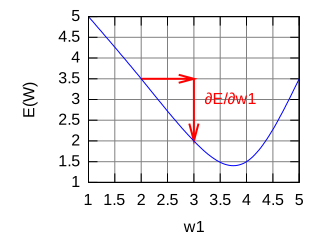
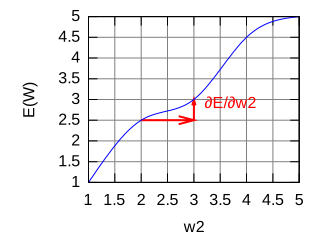
\(\bigtriangledown E \equiv \frac{\partial E}{\partial w} = \begin{bmatrix} \frac{\partial E}{\partial w_{1}} & ... & \frac{\partial E}{\partial w_{m}} \end{bmatrix}^T \\ w^{(t+1)} = w^{(t)} - \varepsilon \bigtriangledown E \)
\(E_{t}(w) = \frac{1}{N_{t}} \sum_{n \in D_{t}} E_{n}(w) \\ \\ D_1 = \big\{(x_{931},d_{931}),(x_{81},d_{81}),...(x_{233},d_{233})\big\} \\ D_2 = \big\{(x_{5},d_{5}),(x_{534},d_{534}),...(x_{111},d_{111})\big\} \\ D_3 = \big\{(x_{432},d_{432}),(x_{68},d_{68}),...(x_{134},d_{134})\big\} \\ ... \)
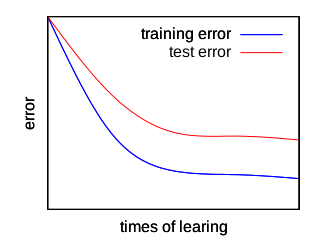
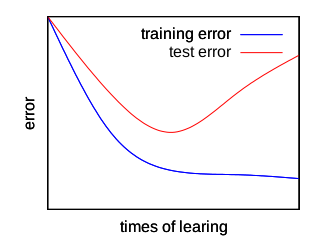
\(E_{t}(w) = \frac{1}{N_{t}} \sum_{n \in D_{t}} E_{n}(w) + \frac{ \lambda }{2} \|w\|^{2} \\ \lambda = 0.01 〜 0.00001 \)
誤差関数に、重みの二乗和の項を追加する
→ 誤差関数が小さくなるように学習を進めるので、より小さな w が選好される
\(\sum_i w_{ji}^2 < c \)
各 j 層において、重みの二乗和が、定数 c より小さくなるようにする。
while ( square_sum(w[j]) > c ) {
  for (i = 0; i < size; i++) {
    w[j][i] = w[j][i] * 0.99;
  }
}
X(1)=(温度1, 湿度1, 圧力1)
X(2)=(温度2, 湿度2, 圧力2)
X(3)=(温度3, 湿度3, 圧力3)
...
なら、学習に用いるデータは
I(1)=(温度1の標準化スコア, 湿度1の標準化スコア, 圧力1の標準化スコア)
I(2)=(温度2の標準化スコア, 湿度2の標準化スコア, 圧力2の標準化スコア)
I(3)=(温度3の標準化スコア, 湿度3の標準化スコア, 圧力3の標準化スコア)
...
\(x_{ni} \leftarrow \frac{x_{ni} - \overline{x_{i}} }{ \sigma_{i} } \\ ただし \sigma_{i} = \sqrt{\frac{1}{N} \sum_{n=1}^N (x_{ni} - \overline{x_{i}}} ) ^ 2 \)
→ 各成分を 平均 0、分散 1 になるように加工する\(x_{ni} \leftarrow \frac{x_{ni} - \overline{x_{i}} }{ max(\sigma_{i},\epsilon) } \\ (εは小さな値) \)
がよく使われる\(w^{(t+1)} = w^{(t)} - \varepsilon \bigtriangledown E \)
\(\epsilon_{t} = \epsilon_{0} - \alpha t \)
\(\epsilon = \epsilon / 10 \)
\(w^{(t+1)} = w^{(t)} - \varepsilon \bigtriangledown E \)
\(\bigtriangledown E の i 成分を g_{ti} として \\ w^{(t+1)}_{i} = w^{(t)}_{i} - \frac{\epsilon}{ \sqrt{ \sum_{t'=1}^t g_{t'i}^2 } } g_{ti} \)
→ その学習で、平均から外れて 良い/悪い 調整を行った \(w_{i}\) を重視して重みの更新を行う

\(w^{(t+1)} = w^{(t)} - \varepsilon \bigtriangledown E + \mu \Delta w^{(t-1)} \)
μ=0.9 のとき、学習が 10 倍早く進む。最適解を通り越しちゃうかもしれんけど\(u^{(l+1)} = Wz^{(l)} + b^{(l)} \\ z^{(l+1)} = f(u^{(l+1)}) \)
\(\begin{bmatrix}u^{(l+1)}_1\\ \vdots \\ u^{(l+1)}_J \end{bmatrix} = \begin{bmatrix}w^{(l)}_{11} & \cdots & w^{(l)}_{1I} \\ \vdots & \ddots & \vdots \\ w^{(l)}_{J1} & \cdots & w^{(l)}_{JI} \end{bmatrix} \begin{bmatrix}z^{(l)}_1\\ \vdots \\ z^{(l)}_I \end{bmatrix} + \begin{bmatrix}b^{(l)}_1\\ \vdots \\ b^{(l)}_J \end{bmatrix} \\ \begin{bmatrix}z^{(l+1)}_1\\ \vdots \\ z^{(l+1)}_J \end{bmatrix} = \begin{bmatrix}f(u^{(l+1)}_1)\\ \vdots \\ f(u^{(l+1)}_J) \end{bmatrix} \)
\(u^{(l+1)} = Wz^{(l)} \\ z^{(l+1)} = f(u^{(l+1)}) \)
\(\begin{bmatrix}u^{(l+1)}_1\\ \vdots \\ u^{(l+1)}_J \end{bmatrix} = \begin{bmatrix}b^{(l)}_{1} & w^{(l)}_{11} & \cdots & w^{(l)}_{1I} \\ \vdots & \vdots & \ddots & \vdots \\ b^{(l)}_{J} & w^{(l)}_{J1} & \cdots & w^{(l)}_{JI} \end{bmatrix} \begin{bmatrix}+1 \\ z^{(l)}_1\\ \vdots \\ z^{(l)}_I \end{bmatrix} \\ \begin{bmatrix}z^{(l+1)}_1\\ \vdots \\ z^{(l+1)}_J \end{bmatrix} = \begin{bmatrix}f(u^{(l+1)}_1)\\ \vdots \\ f(u^{(l+1)}_J) \end{bmatrix} \)

\(\frac{\partial E}{\partial U^{(l)}} = \frac{\partial E}{\partial Z^{(l)}} \frac{\partial Z^{(l)}}{\partial U^{(l)}} \\ = \frac{\partial E}{\partial U^{(l+1)}} \frac{\partial U^{(l+1)}}{\partial Z^{(l)}} \frac{\partial Z^{(l)}}{\partial U^{(l)}} \\ = \frac{\partial E}{\partial U^{(l+1)}} \frac{\partial (W^{(l+1)} Z^{(l)})}{\partial Z^{(l)}} \frac{\partial f(U^{(l)})}{\partial U^{(l)}} \\ = \frac{\partial E}{\partial U^{(l+1)}} W^{(l+1)} f'(U^{(l)}) \)
ここで、\(\delta_{l} = \frac{\partial E}{\partial U^{(l)}}\) とすると\(\delta_{l} = \delta_{l+1} W^{(l+1)} f'(U^{(l)}) \)
つまり、ネットワークの出力層の \(\delta_{L}\) が求まれば、出力層から入力層に向かって順番に \(\delta_{l}\) が求まる。⇒ この操作が、誤差"逆"伝播\(\frac{\partial E}{\partial W^{(l)}} = \frac{\partial E}{\partial U^{(l)}} \frac{\partial U^{(l)}}{\partial W^{(l)}} \\ = \frac{\partial E}{\partial U^{(l)}} \frac{\partial (W^{(l)} Z^{(l-1)})}{\partial W^{l}} \\ = \frac{\partial E}{\partial U^{(l)}} Z^{(l-1)} \\ = \delta_{l} Z^{(l-1)} \)
\(u^{(l+1)} = W^{(l+1)} z^{(l)} \\ z^{(l+1)} = f(u^{(l+1)}) \)
\(\begin{bmatrix}u^{(l+1)}_1\\ \vdots \\ u^{(l+1)}_J \end{bmatrix} = \begin{bmatrix}b^{(l)}_{1} & w^{(l)}_{11} & \cdots & w^{(l)}_{1I} \\ \vdots & \vdots & \ddots & \vdots \\ b^{(l)}_{J} & w^{(l)}_{J1} & \cdots & w^{(l)}_{JI} \end{bmatrix} \begin{bmatrix}+1 \\ z^{(l)}_1\\ \vdots \\ z^{(l)}_I \end{bmatrix} \\ \begin{bmatrix}z^{(l+1)}_1\\ \vdots \\ z^{(l+1)}_J \end{bmatrix} = \begin{bmatrix}f(u^{(l+1)}_1)\\ \vdots \\ f(u^{(l+1)}_J) \end{bmatrix} \)
\(\delta^{(l)} = f'(u^{(l)}) \odot (W^{(l+1)T} \delta^{(l+1)}) \)
\(\begin{bmatrix}\delta^{(l)}_0 \\ \delta^{(l)}_1 \\ \vdots \\ \delta^{(l)}_I \end{bmatrix} = \begin{bmatrix}+1 \\ f'(u^{(l)}_1) \\ \vdots \\ f'(u^{(l)}_I) \end{bmatrix} \odot \big( \begin{bmatrix}b^{(l+1)}_1 & \cdots & b^{(l+1)}_J \\ w^{(l+1)}_{11} & \cdots & w^{(l+1)}_{J1} \\ \vdots & \ddots & \vdots \\ w^{(l+1)}_{1I} & \cdots & w^{(l+1)}_{JI} \end{bmatrix} \begin{bmatrix}\delta^{(l+1)}_1 \\ \vdots \\ \delta^{(l+1)}_J \end{bmatrix} \big) \)
\(※ C \equiv A \odot B ⇔ c_{ij} = a_{ij} b_{ij} \)
\(\frac{\partial E_n}{\partial W^{(l)}} = \delta^{(l)} z^{(l-1)T} \)
\(\begin{bmatrix}b^{(l)}_{1} & w^{(l)}_{11} & \cdots & w^{(l)}_{1I} \\ \vdots & \vdots & \ddots & \vdots \\ b^{(l)}_{J} & w^{(l)}_{J1} & \cdots & w^{(l)}_{JI} \end{bmatrix} = \begin{bmatrix}\delta^{(l)}_0 \\ \delta^{(l)}_1 \\ \vdots \\ \delta^{(l)}_J \end{bmatrix} \begin{bmatrix}z^{(l-1)}_0 z^{(l-1)}_1 \cdots z^{(l-1)}_I \end{bmatrix} = \begin{bmatrix}\delta^{(l)}_0 \\ \delta^{(l)}_1 \\ \vdots \\ \delta^{(l)}_J \end{bmatrix} \begin{bmatrix}+1~z^{(l-1)}_1 \cdots z^{(l-1)}_I \end{bmatrix} \)
\(\Delta^{(l)} = f'(U^{(l)}) \odot (W^{(l+1)T} \Delta^{(l+1)}) \)
\(\begin{bmatrix}\delta^{(l)}_{01} & \cdots & \delta^{(l)}_{0N} \\ \delta^{(l)}_{11} & \cdots & \delta^{(l)}_{1N} \\ \vdots & \ddots & \vdots \\ \delta^{(l)}_{I1} & \cdots & \delta^{(l)}_{IN} \end{bmatrix} = \begin{bmatrix}+1 & \cdots & +1 \\ f'(u^{(l)}_{11}) & \cdots & f'(u^{(l)}_{1N}) \\ \vdots & \ddots & \vdots \\ f'(u^{(l)}_{I1}) & \cdots & f'(u^{(l)}_{IN}) \end{bmatrix} \odot \big( \begin{bmatrix}b^{(l+1)}_1 & \cdots & b^{(l+1)}_J \\ w^{(l+1)}_{11} & \cdots & w^{(l+1)}_{J1} \\ \vdots & \ddots & \vdots \\ w^{(l+1)}_{1I} & \cdots & w^{(l+1)}_{JI} \end{bmatrix} \begin{bmatrix}\delta^{(l+1)}_{11} & \cdots & \delta^{(l+1)}_{1N} \\ \vdots & \ddots & \vdots \\ \delta^{(l+1)}_{J1} & \cdots & \delta^{(l+1)}_{JN} \end{bmatrix} \big) \)
\(\frac{\partial E}{\partial W^{(l)}} = \frac{1}{N} \Delta^{(l)} Z^{(l-1)T} \)
\(\begin{bmatrix}b^{(l)}_{1} & w^{(l)}_{11} & \cdots & w^{(l)}_{1I} \\ \vdots & \vdots & \ddots & \vdots \\ b^{(l)}_{J} & w^{(l)}_{J1} & \cdots & w^{(l)}_{JI} \end{bmatrix} = \frac{1}{N} \begin{bmatrix}\delta^{(l)}_{01} & \cdots & \delta^{(l)}_{0N} \\ \delta^{(l)}_{11} & \cdots & \delta^{(l)}_{1N} \\ \vdots & \ddots & \vdots \\ \delta^{(l)}_{J1} & \cdots & \delta^{(l)}_{JN} \end{bmatrix} \begin{bmatrix} +1&z^{(l-1)}_{11} & \cdots & z^{(l-1)}_{I1}\\ +1&z^{(l-1)}_{12} & \cdots & z^{(l-1)}_{I2}\\ \vdots & \vdots & \ddots & \vdots \\ +1&z^{(l-1)}_{1N} & \cdots & z^{(l-1)}_{IN}\\ \end{bmatrix} \)
\(f(u) = \frac{1}{1+e^{-u}} \\ f'(u) = f(u)(1-f(u)) \)
\(f(u) = tanh(u) \\ f'(u) = 1-tanh^2(u) \)
\(f(u) = max(u,0) \\ f'(u) = \begin{cases}1 & u \geq 0\\0 & u < 0\end{cases} \)
\(Y = U = Z \)
\(E(W) = \frac{1}{2} \sum_{n=1}^{N} \| d_n - y(x_n;W) \|^2 \)
※ 1/2 は、微分した時に係数が出てこないようにするため\(\delta^{(L)} = Y - D \)
\(y=\frac{1}{1+e^{-u}} \\ d=\begin{cases}0 & y < 0.5\\1 & 0.5 \leq y\end{cases} \)
\(E(W) = -log(L(W)) = - \sum_{n=1}^N \big\{ d_{n} log(y(x_{n};W)) + (1 - d_{n}) log(1-y(x_{n};W)) \big\} \)
\(\delta^{(L)} = Y - D \)
※ 青本では D-Y となっているけど多分誤植\(y_{k} = z_{k}^{(L)} = \frac{exp(u_{k}^{(L)})}{ \sum_{j=1}^{K} exp(u_{j}^{(L)}) } \)
softmax function は、合計が 1 になる ⇒ これを入力画像 x が与えられた時の y0〜y9 の確率分布と見なす\(E(W) = -log(L(W)) = - \sum_{n=1}^N \sum_{k=1}^K d_{nk} log(y_{k}(x_{n};W)) \)
\(\delta^{(L)} = Y - D \)
\(\frac{\partial E}{\partial w_{ji}} \approx \frac{E(W') - E(W)}{\epsilon}\\ \epsilon = \begin{cases} \epsilon_c |w_{ji}|\\ \epsilon_c & \epsilon_c |w_{ji}| が計算に使う浮動小数点形式で 0 のとき \end{cases} \)
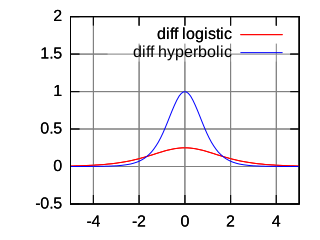
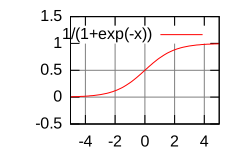
\(f(u) = \frac{1}{1+e^{-u}} \\ f'(u) = f(u)(1-f(u)) \)
微分値(diff logistic)の最大値は u=0 のとき f'(0)=0.25\(f(u) = tanh(u) \\ f'(u) = 1-tanh^2(u) \)
微分値(diff hyperbolic)の最大値は u=0 のとき f'(0)=1\(f(u) = max(u,0) \\ f'(u) = \begin{cases}1 & u \geq 0\\0 & u < 0\end{cases} \)
\(w_{ji} = N(0,\sigma ^2) \)
\(u_{j} = \sum_i^M w_{ji} x_{i} \)
が調度良い分散を持つ σ は何か?\(\sigma_{u_{j}}^2 = \sum_i^M w_{ji}^2 \sigma_{x_{i}}^2 \)
きちんと σ が調整されていて、x の分散が 1 になっているとすると\(\sigma_{u_{j}}^2 = \sum_i^M w_{ji}^2 \)
\(w_{ji}\) の平均を 0 とすると\(\sigma_{u_{j}}^2 = \sum_i^M ( w_{ji} - 0 )^2 = \sum_i^M ( w_{ji} - \overline{w_{ji}} )^2 \)
両辺を M で割ると\(\frac{\sigma_{u_{j}}^2}{M} = \frac{ \sum_i^M ( w_{ji} - \overline{w_{ji}} )^2 }{M} = \sigma^2 \\ \therefore \sigma = \frac{\sigma_{u_{j}}}{\sqrt{M}} \)

\(\Phi_X = \frac{1}{N} X X^T \)
\(\Phi_U = \frac{1}{N} (PX) (PX)^T \)
\(I = (PX) (PX)^T = PXX^{T}P^{T} \\ \therefore P^{-1} (P^{T})^{-1} = XX^{T} = \Phi_X \\ \therefore \Phi_X^{-1} = P^{T} P \)
\(\Phi_{X} \overrightarrow{e_{i}} = \lambda_{i} \overrightarrow{e_{i}} \\ \Phi_{X} [\overrightarrow{e_{1}} \overrightarrow{e_{2}} \dots \overrightarrow{e_{n}}] = [\overrightarrow{e_{1}} \overrightarrow{e_{2}} \dots \overrightarrow{e_{n}}] \begin{bmatrix} \lambda_{1} & 0 & \dots & 0 \\ 0 & \lambda_{2} & \dots & 0 \\ \vdots & \vdots & \ddots & \vdots \\ 0 & 0 & \dots & \lambda_{n} \end{bmatrix} \\ \Phi_{X} E = E \Lambda \\ \\ \therefore \Phi_{X} = E \Lambda E^{-1} \\ \therefore \Phi_{X}^{-1} = E (E \Lambda)^{-1} = E \Lambda^{-1} E^{-1} = E \Lambda^{-1} E^{T} \\ \)
\(\Phi_{X}^{-1} = E \Lambda^{-1} E^{T} = E \Lambda^{-1/2} Q^{T} Q \Lambda^{-1/2} E^{T} = (Q \Lambda^{-1/2} E^{T})^{T} (Q \Lambda^{-1/2} E^{T}) = P^{T} P \\ \therefore P = Q \Lambda^{-1/2} E^{T} \)
※ \(\Lambda^{-1/2}\) は、対角成分が \(\sqrt{\lambda_{i}}\) の対角行列\(P_{PCA} = \Lambda^{-1/2} E^{T} \)
変換行列 \(P_{PCA}\) は、ほぼ 固有ベクトル。変換行列の意味するところは、主成分分析と同じ\(P_{ZCA} = E \Lambda^{-1/2} E^{T} \)
E を回転行列と見ると、\(P_{ZCA}\) による写像で位相は変わらない → ゼロ位相成分分析\(P_{PCA} = (\Lambda^{-1/2} + \epsilon I) E^{T} \\ P_{ZCA} = E (\Lambda^{-1/2} + \epsilon I) E^{T} \\ \epsilon = 10^{-6} \)


\(y = w_1 x_1 + w_2 x_2 + \dots + w_{100} x_{100} + \epsilon \)
y : 応答変数 (出力)\(\begin{bmatrix}y_1 \\ y_2 \\ \vdots \\ y_{100} \end{bmatrix} = \begin{bmatrix} x_{1~1} & x_{1~2} & \dots & x_{1~100} \\ x_{2~1} & x_{2~2} & \dots & x_{2~100} \\ \vdots & \vdots & \ddots & \vdots \\ x_{100~1} & x_{100~2} & \dots & x_{100~100} \\ \end{bmatrix} \begin{bmatrix}w_1 \\ w_2 \\ \vdots \\ w_{100} \end{bmatrix} + \epsilon \)
を解く必要がある。⇒ 最低 100 個観測データ (X,Y) が必要で、観測データ数が多くなればなるほどノイズ ε を小さくできる\(y = w_1 x_1 + w_2 x_2 + \dots + w_{100} x_{100} + \epsilon \\ = w_1 x_1 + w_2 x_2 + w_3 x_3 + \epsilon \)
つまり、さっき用意した 100個の観測データについて\(\begin{bmatrix}y_1 \\ y_2 \\ \vdots \\ y_{100} \end{bmatrix} = \begin{bmatrix} x_{1~1} & x_{1~2} & x_{1~3} \\ x_{2~1} & x_{2~2} & x_{2~3} \\ \vdots & \vdots & \vdots \\ x_{100~1} & x_{100~2} & x_{100~3} \\ \end{bmatrix} \begin{bmatrix}w_1 \\ w_2 \\ w_3 \end{bmatrix} + \epsilon \)
となる。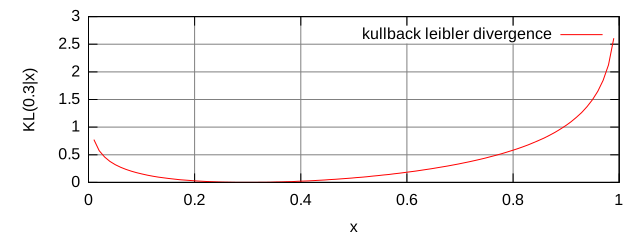
\(KL( \rho || \widehat{\rho}_j ) = \rho~log\frac{\rho}{\widehat{\rho}_j} + (1-\rho)~log\frac{(1-\rho)}{(1-\widehat{\rho}_j)} \)
\(KL(P||Q) = \int_{- \infty }^{ \infty } p(x)~log \frac{p(x)}{q(x)} ~dx \)
\(P(X=1) = p \\ P(X=0) = q = 1- p \\ f(k;p) = p^k (1-p)^{1-k}~~for~k \in \{0,1\} \)
\(p(x) = f(x;\rho) = \rho^x (1-\rho)^{1-x}~~for~x \in \{0,1\} \\ q(x) = f(x;\widehat{\rho}_j) = \widehat{\rho}_j^x (1-\widehat{\rho}_j)^{1-x}~~for~x \in \{0,1\} \\ \\ KL(P||Q) = \int_{- \infty }^{ \infty } p(x)~log \frac{p(x)}{q(x)} ~dx \\ = p(1)~log \frac{p(1)}{q(1)} + p(0)~log \frac{p(0)}{q(0)}~~~\because for~x \in \{0,1\}\\ = \rho~log\frac{\rho}{\widehat{\rho}_j} + (1-\rho)~log\frac{(1-\rho)}{(1-\widehat{\rho}_j)} // \)
\(\widetilde{E}(w) = E(w) + \beta \sum_{j=1}^{D_l} KL(\rho || \widehat{\rho_j}) \\ ~~\widehat{\rho_j} = \frac{1}{N} \sum_{n=1}^{N} z_j(x_n) \\ ~~KL(\rho || \widehat{\rho_j}) = \rho~log (\frac{\rho}{\widehat{\rho_j}}) + (1 - \rho)~log \frac{(1 - \rho)}{(1 - \widehat{\rho_j})} \)
\(\delta_{j}^{(l)} = \frac{\partial \widetilde{E}(w)}{\partial u_{j}^{(l)}} = \frac{\partial E(w)}{\partial u_{j}^{(l)}} + \frac{\partial}{\partial u_{j}^{(l)}} (\beta \sum_{j=1}^{D_l} KL(\rho || \widehat{\rho_j})) \\ = \frac{\partial E(w)}{\partial u_{j}^{(l)}} + \beta \frac{\partial (KL(\rho || \widehat{\rho_j}))}{\partial \widehat{\rho_j}} \frac{\partial \widehat{\rho_j}}{\partial u_{j}^{(l)}} \)
\(\frac{\partial E(w)}{\partial u_{j}^{(l)}} = \sum_k \delta_k^{(l+1)} w_{kj}^{(l+1)} f'(u_j^{(l)}) \)
\(\frac{\partial (KL(\rho || \widehat{\rho_j}))}{\partial \widehat{\rho_j}} \\ = \frac{\partial}{\partial \widehat{\rho_j}} (\rho~log (\frac{\rho}{\widehat{\rho_j}}) + (1 - \rho)~log \frac{(1 - \rho)}{(1 - \widehat{\rho_j})}) \\ = \frac{\partial}{\partial \widehat{\rho_j}} (\rho~log (\rho~\widehat{\rho_j}^{-1}) + (1 - \rho)~log ((1 - \rho)(1 - \widehat{\rho_j})^{-1})) \\ = \rho \frac{- \rho~\widehat{\rho_j}^{-2} }{ \rho~\widehat{\rho_j}^{-1} } + (1-\rho) \frac{- (1-\rho)~(1-\widehat{\rho_j})^{-2} }{ (1-\rho)~(1-\widehat{\rho_j})^{-1} } \bullet -1 \\ = \frac{- \rho}{ \widehat{\rho_j} } + \frac{ (1-\rho) }{ (1-\widehat{\rho_j}) } \)
cf.\((log(f(x)))' = \frac {f'(x)}{f(x)}\)\(\widehat{\rho_j} = \frac{1}{N} \sum_{n=1}^{N} z_j(x_n) = \frac{1}{N} \sum_{n=1}^{N} f(u_j^{(l)}) \\ \therefore \frac{\partial \widehat{\rho_j}}{\partial u_{j}^{(l)}} = f'(u_{j}^{(l)}) \)
\(\therefore \delta_{j}^{(l)} = \left\{ \sum_k \delta_k^{(l+1)} w_{kj}^{(l+1)} + \beta ( \frac{- \rho}{ \widehat{\rho_j} } + \frac{1-\rho}{1-\widehat{\rho_j}} ) \right\} f'(u_{j}^{(l)}) \)
\(\delta^{(l)} = f'(u^{(l)}) \odot (W^{(l+1)T} \delta^{(l+1)} + \beta \Theta) \)
\(\begin{bmatrix}\delta^{(l)}_0 \\ \delta^{(l)}_1 \\ \vdots \\ \delta^{(l)}_I \end{bmatrix} = \begin{bmatrix}+1 \\ f'(u^{(l)}_1) \\ \vdots \\ f'(u^{(l)}_I) \end{bmatrix} \odot \big( \begin{bmatrix}b^{(l+1)}_1 & \cdots & b^{(l+1)}_J \\ w^{(l+1)}_{11} & \cdots & w^{(l+1)}_{J1} \\ \vdots & \ddots & \vdots \\ w^{(l+1)}_{1I} & \cdots & w^{(l+1)}_{JI} \end{bmatrix} \begin{bmatrix}\delta^{(l+1)}_1 \\ \vdots \\ \delta^{(l+1)}_J \end{bmatrix} + \beta \begin{bmatrix}\theta^{(l+1)}_1 \\ \vdots \\ \theta^{(l+1)}_J \end{bmatrix} \big) \\ \theta^{(l+1)}_j = \frac{- \rho}{ \widehat{\rho_j} } + \frac{1-\rho}{1-\widehat{\rho_j}} \)
\(※ C \equiv A \odot B ⇔ c_{ij} = a_{ij} b_{ij} \)
\(\widehat{\rho_j}^{(t)} = \lambda~\widehat{\rho_j}^{(t-1)} + (1-\lambda)\widehat{\rho_j} \)


\(u_{ij} = \sum_{p=0}^{H-1} \sum_{q=0}^{H-1} x_{i+p,j+q} h_{pq} \)
\(u_{ij} = \sum_{p=0}^{H-1} \sum_{q=0}^{H-1} x_{si+p,sj+q} h_{pq} \)
※ 元画像が巨大過ぎる場合を除いて畳み込み層ではストライドはしない (プーリング層では通常ストライドする)
\(u_{ijm} = \sum_{k=0}^{K-1} \sum_{p=0}^{H-1} \sum_{q=0}^{H-1} z_{i+p,j+q,k}^{(l-1)} h_{pqkm} + b_{ijm} \\ z_{ijm} = f( u_{ijm} ) \)

\(u_{ijk} = \max_{(p,q) \in P_{ij}} z_{pqk} \)
\(u_{ijk} = \frac{1}{H^2} \sum_{(p,q) \in P_{ij}} z_{pqk} \)
\(u_{ijk} = (\frac{1}{H^2} \sum_{(p,q) \in P_{ij}} z_{pqk}^P)^\frac{1}{P} \)
| コントラスト正規化 | 入力画像 (1,2,...,N) のコントラストを正規化して学習しやすくする | |
| 局所コントラスト正規化 | 画像認識のネットワークに組み込む。畳込みやプーリングで輝度が飽和するのを防ぐ | |
| 減算正規化 | (i,j)の画素値を(i,j)周辺の重み付き平均にする | |
| 除算正規化 | (i,j)の画素値を(i,j)周辺の重み付き分散で割る。変化の少ない箇所の濃淡を強調する処理を行う | |
\(\widetilde{x}_{ijk} = \Sigma_{n=1}^{N} x_{ijk}^{(n)} \\ x_{ijk} \leftarrow x_{ijk} - \widetilde{x}_{ijk} \)
(i,j) kチャンネル の画素値から全データの平均値を引く
\(\widetilde{x}_{ijk} = \Sigma_{(p,q) \in P_{ij}} w_{pq} x_{i+p,j+q} \\ x_{ij} \leftarrow x_{ij} - \widetilde{x}_{ij} \)
適当な重み \(w_{pq}\) で周辺の画素の重み付き平均をとって、画素値 \(x_{ij}\) から減算する。\(\Sigma_{(p,q) \in P_{ij}} w_{pq} = 1 \\ w_{ij} \geq w_{pq}\ (for\ each\ (p,q) \in P_{ij}) \)
重みの合計は 1 になるようにして*1、中心 (i,j) の重みが一番大きくなるようにする*2。\(\overline{x}_{ij} = \frac{1}{H^2} \Sigma_{(p,q) \in P_{ij}} x_{i+p,i+q} \\ \sigma_{ij}^2 = \Sigma_{(p,q) \in P_{ij}} w_{pq} (x_{i+p,i+q} - \overline{x}_{ij})^2 \\ x_{ij} \leftarrow \frac{x_{ij} - \overline{x}_{ij}}{\sigma_{ij}} \)
(H は Pij の縦横長)\(x_{ij} \leftarrow \frac{x_{ij} - \overline{x}_{ij}}{max(c,\sigma_{ij})} \\ \)
\(x_{ij} \leftarrow \frac{x_{ij} - \overline{x}_{ij}}{\sqrt{c + \sigma_{ij}^2}} \\ \)
(c = 1.0 など)\(\Sigma_{(p,q) \in P_{ij}} w_{pq} = 1 \\ w_{ij} \geq w_{pq}\ (for\ each\ (p,q) \in P_{ij}) \)
重みの合計は 1 になるようにして*3、中心 (i,j) の重みが一番大きくなるようにする*4。\(\widetilde{x}_{ij} = \frac{1}{K} \Sigma_{k=0}^{K-1} \Sigma_{(p,q) \in P_{ij}} w_{pq} x_{i+p,j+q,k} \\ x_{ijk} \leftarrow x_{ijk} - \widetilde{x}_{ij} \)
\(\overline{x}_{ij} = \frac{1}{KH^2} \Sigma_{k=0}^{K-1} \Sigma_{(p,q) \in P_{ij}} x_{i+p,i+q,k} \\ \sigma_{ij}^2 = \frac{1}{K} \Sigma_{k=0}^{K-1} \Sigma_{(p,q) \in P_{ij}} w_{pq} (x_{i+p,i+q,k} - \overline{x}_{ij})^2 \\ x_{ijk} \leftarrow \frac{x_{ijk} - \overline{x}_{ij}}{\sigma_{ij}} \)
ノイズが強調されないように分母に手を加えてもよい\(x_{ijk} \leftarrow \frac{x_{ijk} - \overline{x}_{ij}}{max(c,\sigma_{ij})} \\ \)
\(x_{ijk} \leftarrow \frac{x_{ijk} - \overline{x}_{ij}}{\sqrt{c + \sigma_{ij}^2}} \\ \)
(c = 1.0 など)
\(u^{(l)} = W^{(l)} z^{(l-1)} + b^{(l)} \\ z^{(l)} = f^{(l)}(u^{(l)}) \\ \partial W = \delta^{(l)} z^{(l-1)} \)
\(W = Th \\ \partial W = \partial (Th) \\ \partial h = T \partial W \)


 srnn2.png 2053件
[詳細]
 srnn1.png 2069件
[詳細]
 rnn.png 2067件
[詳細]
 convolution_delta.png 2064件
[詳細]
 lcn.png 2250件
[詳細]
 pooling.png 2479件
[詳細]
 rgb_convolution.png 2468件
[詳細]
 convolution_calc.png 2474件
[詳細]
 convolution_network.png 2528件
[詳細]
 convolution.png 2419件
[詳細]
 denoiseing.png 2252件
[詳細]
 self_encode2.png 2227件
[詳細]
 self_encode.png 2201件
[詳細]
 principal_analysis.png 2212件
[詳細]
 float.png 1010件
[詳細]
 double.png 1043件
[詳細]
 backpropagation.png 2138件
[詳細]
 momentum2.png 2232件
[詳細]
 momentum1.png 2281件
[詳細]


